Что такое токены в ChatGPT и как они считаются?
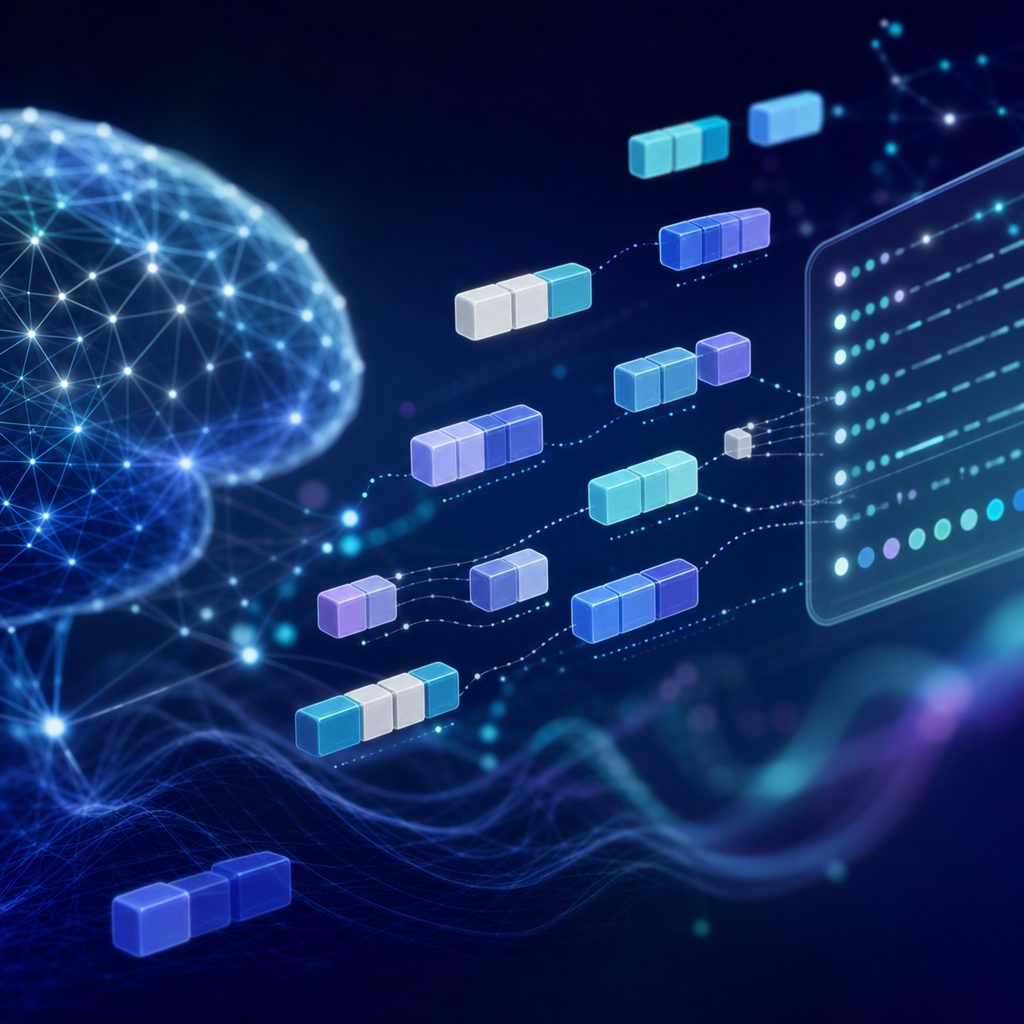
Токены — это единицы, которыми нейросети измеряют текст. Проще говоря, это не слова, а «кусочки» информации, которые модель обрабатывает за раз. Когда вы пишете запрос или получаете ответ, нейросеть считает токены, а не буквы или слова. Именно от их количества зависит, сколько вы заплатите и насколько длинным может быть диалог.
Как нейросеть «режет» текст на токены
Представьте, что вы даёте роботу текст, а он режет его на мелкие кусочки — токены. Одно короткое слово вроде «привет» — это один токен. Длинное слово «здравствуйте» может весить два-три токена. Пробелы, знаки препинания, даже часть кода — всё это тоже считается. Например, фраза «Здравствуйте, уважаемый пользователь!» превратится примерно в 5–6 токенов. Английский текст обычно дробится мельче, русский — чуть крупнее, потому что слова длиннее.
Каждая модель использует свой «словарь» токенов. Современные нейросети — GPT-5.5, GPT-5.4, GPT-5.4 mini, Claude, Gemini, DeepSeek, Grok, Qwen, Kimi, Perplexity — все работают по одному принципу: они не видят буквы, они видят токены. Поэтому чем больше токенов в запросе и ответе, тем больше ресурсов тратит модель и тем дороже для вас обходится диалог.
Зачем считать токены обычному пользователю
Если вы просто общаетесь с нейросетью, токены остаются за кадром. Но как только вы начинаете задумываться о стоимости или длине диалога, без них не обойтись. Вот главные причины:
- Оплата. На странице тарифов вы покупаете кредиты — разовым пакетом или подпиской. Кредиты списываются за токены запроса и ответа, причём у каждой модели свой коэффициент: лёгкая тратит меньше, тяжёлая в несколько раз больше. Короткий вопрос — дёшево, длинное сочинение — дороже.
- Ограничение контекста. У каждой модели есть «окно» — максимальное количество токенов, которое она может запомнить за один раз. Если диалог переваливает за лимит, модель «забывает» начало. Например, у GPT-5.5 окно большое, а у GPT-5.4 mini — поменьше.
- Выбор модели. Для быстрых мелочей выгоднее лёгкая модель вроде GPT-5.4 mini — она тратит меньше токенов на тот же ответ. Для сложных задач лучше взять мощную GPT-5.5 или Claude, но они «съедят» больше токенов.
Сколько токенов уходит на типичные задачи
Точные цифры зависят от длины запроса, языка и самой модели, но можно прикинуть средние значения. Например:
- Короткий вопрос вроде «Напиши рецепт борща» — около 50–100 токенов на запрос и ответ.
- Перевод страницы текста (300–500 слов) — 400–700 токенов.
- Написание статьи на 1000 слов — 1500–2500 токенов.
- Длинный диалог с историей (10–20 сообщений) — может легко набрать 4000–6000 токенов.
Разные модели тратят токены по-своему. Например, Gemini и DeepSeek могут быть чуть экономичнее на русском, а Grok или Perplexity — на английском. Но в целом разница не принципиальна для обычного пользователя.
Как токены связаны с тарифами на Lord-GPT.com
На нашем сайте вы выбираете тариф и получаете кредиты: разовым пакетом или ежемесячной подпиской. Когда вы отправляете сообщение любой из доступных моделей — будь то GPT-5.5, Claude, Qwen или Kimi — система списывает кредиты пропорционально длине запроса и ответа и умножает их на коэффициент выбранной модели. Первые несколько сообщений бесплатны, чтобы вы могли попробовать.
Важный нюанс: токены считаются и за то, что вы пишете, и за то, что генерирует нейросеть. Если вы загружаете длинный документ или изображение (в моделях, которые поддерживают картинки), это тоже увеличивает расход. Поэтому для экономии старайтесь формулировать запросы чётко и без лишних деталей.
Подробнее о том, как устроена система кредитов, можно прочитать в статье «Как считаются кредиты». А если хотите выбрать подходящую модель под свою задачу, загляните в раздел готовых ИИ-помощников — там уже настроены оптимальные параметры для разных ситуаций.
Практический вывод: как не переплачивать за токены
Чтобы диалоги оставались недорогими, придерживайтесь нескольких простых правил:
- Формулируйте вопрос сразу полно, без уточняющих переписок. Каждое новое сообщение — это новые токены.
- Не копируйте в чат огромные куски текста без необходимости. Если нужно проанализировать документ, лучше загрузите его как файл (если модель поддерживает) или дайте ссылку.
- Для простых задач (проверка орфографии, короткий ответ) выбирайте лёгкие модели — GPT-5.4 mini, Gemini Flash Lite или Qwen: у них самый низкий коэффициент списания. Perplexity, наоборот, одна из самых дорогих: она ищет ответ в интернете, и кредитов уходит в несколько раз больше. Для творчества или сложного анализа берите мощные модели, но старайтесь не затягивать диалог.
- Следите за длиной ответа: если вам нужно кратко, попросите нейросеть отвечать коротко. Это сэкономит токены с обеих сторон.
В итоге токены — это просто способ измерить, сколько «работы» сделала нейросеть. Понимая это, вы легко сможете управлять своими расходами и выбирать оптимальный тариф на странице с ценами.